Le panorama est fait de classements. Ranger des œuvres ne coûte rien : au pire une case est mal choisie, et personne n'en meurt. Ranger des gens avec la même technique est une autre affaire, et cette page est le détour qui le montre. Elle ne parle pas d'interactivité, mais de l'outil qu'on utilise partout ailleurs sur ce site.
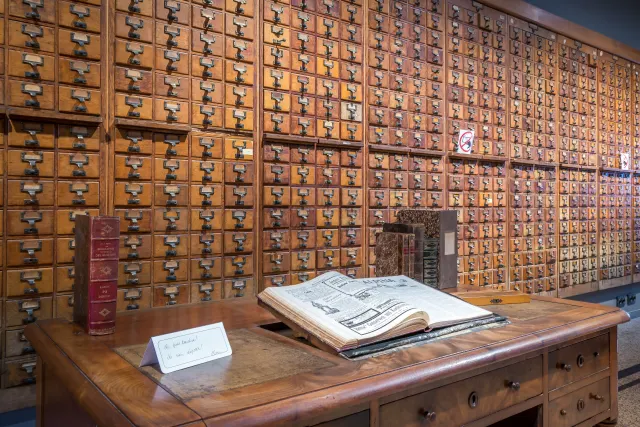

À partir de 1895, à Bruxelles, Paul Otlet et Henri La Fontaine entreprennent de ficher tout ce qui a été publié : une fiche par idée, un code par sujet, dix-huit millions de cartons dans des tiroirs. C'est le Mundaneum. En 1934, Otlet décrit le poste de travail qui irait avec : un écran, un clavier, les documents qui arrivent à distance. Il décrit le web avec cinquante ans d'avance, et il le décrit en meubles.
Ils ne sont pas seuls. La fin du XIXe et le début du XXe siècle classent tout : les espèces, les langues, les métiers, les criminels, les crânes. La même technique (la fiche, le code, le tiroir) sert la bibliographie universelle et le fichier des criminels : Bertillon fiche les corps à la préfecture de Paris dès 1883, douze ans avant qu'Otlet ne fiche les idées.
Le tiroir est devenu un modèle
Ça n'appartient pas au passé. Trier des gens par catégories est aujourd'hui le métier des modèles statistiques, et ils héritent des travers de leurs données. En 2015, Google Photos étiquette des personnes noires « gorilles ». Le correctif a été de retirer le mot du vocabulaire, et pas seulement lui : chimpanzé, babouin, singe. Huit ans plus tard, le New York Times refait le test : les étiquettes manquent toujours, chez Google comme chez Apple. Le mot a disparu, pas le classement.
Le monde selon Stable Diffusion est dirigé par des PDG blancs et masculins. Les femmes y sont rarement médecins, avocates ou juges. Les hommes à la peau foncée commettent des crimes, les femmes à la peau foncée retournent des steaks dans un fast-food.
Les IA génératives ne rangent pas : elles fabriquent. Et elles fabriquent le même monde. Bloomberg a généré des milliers d'images de métiers avec Stable Diffusion, puis les a comptées : 3 % de femmes pour « juge », contre 34 % de juges femmes aux États-Unis. Personne n'a écrit ces règles. Le modèle ne voit pas le monde : il ne voit que ce qu'on lui a donné à regarder, un corpus d'images ramassées sur le web, déjà penché avant lui. Il n'a pas inventé le déséquilibre : il l'a trouvé, et il l'a durci.
C'est le même geste qu'en 1883, avec la même prétention à l'objectivité : la machine ne juge pas, elle mesure. Sauf qu'entre le tiroir et le modèle, il y a une différence de vitesse. La fiche demandait un employé ; le modèle range quelques millions de personnes par jour, et sans registre où aller vérifier.
Les données ne se trouvent pas
Reste la question que tout ça pose et qu'on n'a pas encore posée : d'où viennent les données. Jer Thorp travaille à démonter l'idée qu'elles seraient une matière première, quelque chose qu'on extrait. Une donnée n'existe pas avant que quelqu'un décide de la relever, avec ses cases à lui, et laisse le reste dehors.
Celles de Stable Diffusion sont publiques. Le corpus s'appelle LAION : près de six milliards de paires
image-texte ramassées sur le web, où le texte n'est rien d'autre que
l'attribut alt, la description que des inconnus ont tapée, ou pas, en
publiant leurs photos. Il a ensuite fallu élaguer. Par langue, par
résolution, par risque de filigrane, et par « score esthétique », attribué
de 1 à 10 par un autre modèle entraîné pour ça.
Les décisions se comptent. Que la légende d'une image, ce soit son alt. Que
l'anglais fasse le corpus : le modèle a appris sur la moitié anglophone.
Qu'une machine puisse noter la beauté sur dix. Aucune n'est un fait sur le
monde, chacune est un choix, pris par quelqu'un, un jour, et discutable. Une
fois le corpus constitué, elles ont toutes disparu : il ne reste que des
images, qui ont l'air d'avoir toujours été là.
Le rendre à nouveau audible, c'est exactement ce que fait sa lecture à voix haute de la base du MoMA. Cent vingt-trois mille objets, et dans la liste des prénoms d'artistes les plus fréquents : deux cents John, pas un prénom féminin. Personne n'avait écrit cette règle-là non plus.
Son autre pièce dit l'inverse, et c'est pour ça qu'elle compte ici. Pour graver près de trois mille noms sur le mémorial du 11-Septembre, l'ordre alphabétique tenait en une ligne de code. Avec Jake Barton et Local Projects, il a fait le contraire : recueillir auprès des familles quelque mille cinq cents demandes d'adjacence (tel nom doit toucher tel autre), puis écrire l'algorithme qui les satisfait toutes. L'outil tient dans un programme Processing, c'est-à-dire dans quelque chose d'ordinaire.
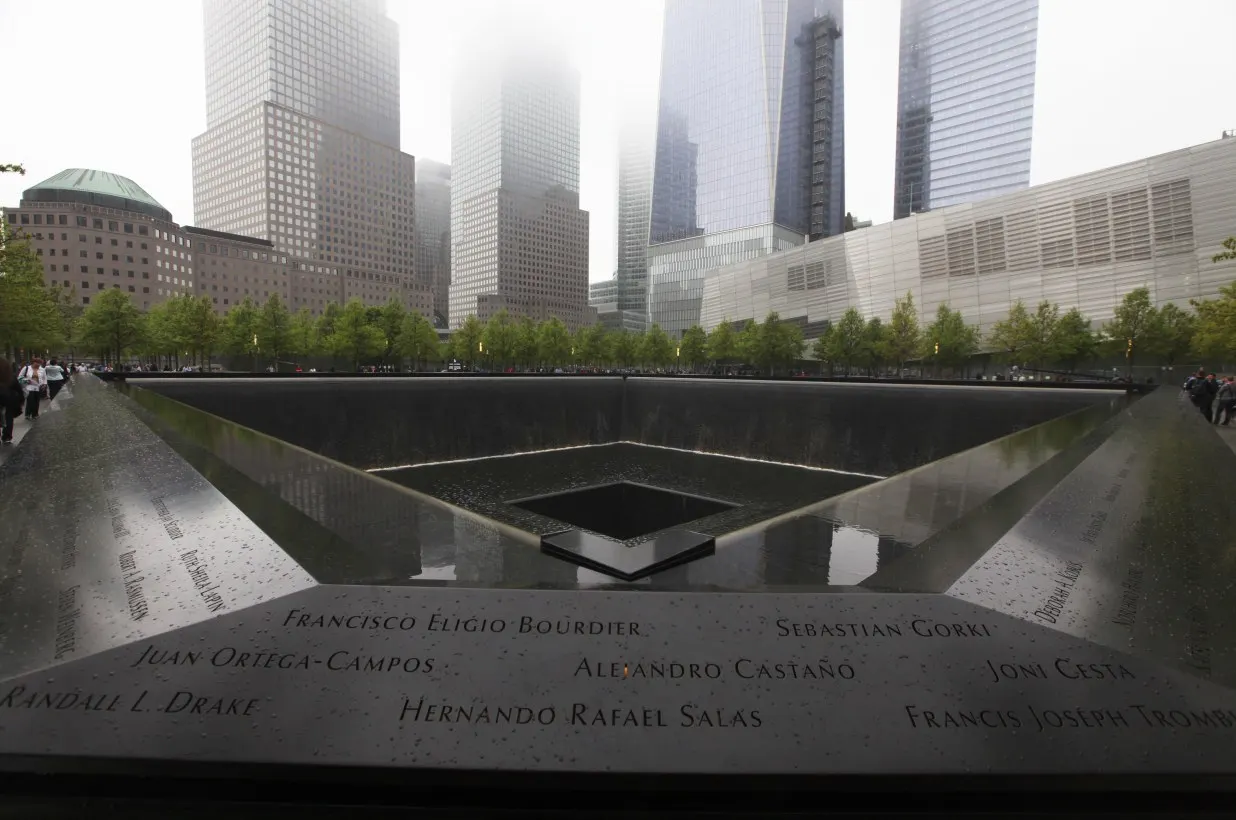
Un classement peut servir les gens qu'il range. Ça ne tombe pas tout seul : ça se décide, et ça se décide à l'écriture, avant le code.
De quoi lire le panorama pour ce qu'il est : des tiroirs, pas des faits. Y compris ceux que je propose ici.